Oczywiście, że tak. Kilka wzorców z SOA Design Patterns:
Pokazywanie postów oznaczonych etykietą SOA. Pokaż wszystkie posty
piątek, stycznia 20, 2017
piątek, maja 15, 2015
poniedziałek, kwietnia 13, 2015
Canonical Data Model
It is hard to create a good CDM. Its architect needs to have long experience with different business areas and knowledge of real life processes, also exceeding scope of the current company. Designer needs to be foreseeing. CDM entity should not just go after two domain systems and merge their attributes. Common parameters should be named and there should be a place for extensions using key-value containers. All current and future systems/messages should fit into current CDM. Popular mistake is to create too tight and too small model which needs serious changes during some project. Another mistake is to create one CDM for whole life-time which is too big and too complex for easy usage. CDM is not given once forever, it evolves over time, constantly and iteratively improving. Not using CDM is the biggest mistake.
czwartek, maja 22, 2014
VAT - Validation of Architecture in Tests
1. Flood test / capacity test
We call component with assumed load, see distribution of response times (min, max, avg, med, 80 percentile, 95 percentile, 99 percentile) - are they deterministic. We increase load linearly up to 10x (one order of magnitude higher) and monitor performance. Components should be able to be tuned to handle load 2x higher than current business requirement. Tests should define limits when below application is still responsive and above crashes.
2 Duplicates test
We call services with duplicated messages and check handling of duplicates. Application may not recognize duplicates, may throw errors due to detection of repeating unique ids and may accept duplicates, but internally skip processing of them. Tests should check for not aimed data multiplication and stalled flows due to rejected duplicates errors.
3 Timeout test
We inject long sleep activities and check timeout handling. We look for snowball effect (backlog aggregation due to repeating on timeout), not defined capacity limits causing whole components/flows to be stucked/failing with OutOfMemory errors, overloaded components and servers.
4 Kill & restart test
We kill and restart whole application/(application) servers. We look for missing (lost) data, duplicates and other inconsistencies. We verify transactional requirements and actual implementation.
5 Error injection and negative path
We inject errors inside process execution and check for missing error handlers. We verify error codes to see if they match actual exception. We also verify assigned error categories (business, technical, repeatable, non-repeatable).
6 Logging test
We check if logging works, payloads are available and we have enough file/database storage. We check if flows are traceable using log frontend.
7. Active-Active, Active-Standby
We kill components and check switching between endpoints. We measure times and verify against configured application timeouts. We detect weak points / single points of failure, recovery errors. It is important to test all possible permutations, with various timings etc. We should create and execute test case when whole HA infrastructure does not deliver working HA for connected applications.
8. Poller test
We run many pollers at once and check if they are protected against working in multithreading. We configure limits to comply with singleton design or implement missing (b)locking. We check data consistency/duplication.
9 Data republication
We check if data republication is possible, how to trigger it, how to detect republication from external systems, how to protect against flood/snowball effect/not controllable backlog.
10 Long term stability test
We execute normal load tests for 24/48/72 hours and check for any stability issues caused by daily IT usage patterns.
piątek, stycznia 24, 2014
Koszty utrzymania projektów Tibco
Jak uczciwie wystawić biznesowi rachunek za koszty infrastrukturalne? Każdy proces BW i każdy przepływ powinny generować zdarzenia "użycia". Zużycie procesora w zadanym czasie może być wyjęte za pomocą JMX-a. Mierząc czasy poszczególnych zadań i dysponując zużyciem procesora w oknie czasowym je obejmującym można oszacować zużycie procesora przez pojedyncze zadanie. Mając statystki procesora, pamięci, przestrzeni przechowywania danych można obliczyć realne koszty zadań Tibco. Mierząc i analizując czasy trwania procesów (średnia, mediana, percentyle: 90, 95, 99) przez dłuższy okres można ocenić wpływ wdrażanych projektów na pozostałe i wyciągać wnioski, czy dla spełnienia starych SLA konieczne jest zwiększenie zasobów przy uruchamianiu nowych projektów. Mając dokładne dane, biznes wie za co płaci. Kosztowne pod względem infrastruktury projekty można przepisać i przez to zoptymalizować.
czwartek, września 12, 2013
Logowanie EAI
Logowanie EAI powinno być wieloaspektowe:
- wszystkie akcje w ramach jednego logicznego przepływu oznaczone tą samą instancją identyfikatora przepływu
- te same logicznie dane w ramach dowolnej akcji oznaczone tym samym użytecznym biznesowo identyfikatorem
- stan zakończenia procesu biznesowego: sukces, błąd biznesowy, błąd techniczny
- statystyki wydajnościowe liczone w czasie wykonania lub surowe dane przetwarzane i raportowane offline
- błędy analizowane w wąskim oknie czasowym raportowane w czasie zbliżonym do rzeczywistego, co pozwala na łatwe zauważenie awarii w powiązanych ze sobą komponentach
piątek, lipca 19, 2013
Skuteczny monitoring EAI
- logi błędów przetwarzane są automatycznie i na ich podstawie generowane są alerty (mail, sms)
- alert zawiera link do dokumentacji komponentowej (jeśli w bazie reguł nie ma poprawnego linku, problem 'za karę' obsługuje przełożony utrzymania)
- dokumentacja komponentowa to jeden dokument MS Word/Open Document, w którym można zrobić Ctrl+F po znaczącej frazie z alertu i w ten sposób zobaczyć znane problemy i obejścia
- dokumentacja komponentowa zawiera miesięczny grafik wsparcia: osoba obsługująca + osoba zapasowa (jeśli wpisy nie są poprawne, problem 'za karę' obsługuje przełożony utrzymania)
- monitoring i wsparcie powinno opierać się na wyuczonych, ustandaryzowanych, procesowych procedurach postępowania
poniedziałek, czerwca 03, 2013
EMS planetary pattern
EMS server holds its state and message structures in memory and therefore has a limit for maximal number of messages. Considering compiler options and memory alignment EMS server requires about 0,5KB per one JMS message. With EMS server using 4GB RAM you can have 8 mln messages.
When memory limit of EMS server is too low you can refactor your infrastructure with planetary pattern:
Applications have their local EMS instances with routing enabled towards master server and defined proxy queues:
billing.data@EMS-SERVER-MASTER store=$sys.failsafe,secure
billing.voice@EMS-SERVER-MASTER store=$sys.failsafe,secure
billing.premium@EMS-SERVER-MASTER store=$sys.failsafe,secure
Master server has limits forced on these queues:
billing.data@EMS-SERVER-MASTER store=$sys.failsafe,secure,maxmsgs=1000000
billing.voice@EMS-SERVER-MASTER store=$sys.failsafe,secure,maxmsgs=1000000
billing.premium@EMS-SERVER-MASTER store=$sys.failsafe,secure,maxmsgs=1000000
When you send messages to local server's queue and master server still has got free capacity - they are routed. When master's limit is reached messages are stored on local server - until master regained capacity.
With EMS planetary pattern you can get rid of EMS server memory limits. If client connects to EMS server via JNDI it can be transparently redirected to other server, so you can migrate easily from single server to planetary infrastructure. If connection factory config is taken from local JNDI you can add additional server behind local EMS without reconfiguring client.
poniedziałek, maja 27, 2013
How to make EMS-centric Tibco BW to be HA
Hihghly available means accessible and consistent. The concept is to synchronize EMS servers across data centers using global queues routing and use pair of them for service endpoints. For highly available transactions BW instances need to have shared object stores for Arjuna XA Transaction Manager.
More complex solution:
Complementary routes from local EMS instances are omitted for picture clarity. TM should not be local to App instance.
And simple solution:
środa, maja 15, 2013
Shield pattern
Application is sensitive to input data. Certain combinations cause it to crash or do not behave correctly (for example: create record and do not perform rollback when processing fails). Create proxy before app and filter input data. Do not allow bad data to flow to app.
Cloud link pattern
Your infrastructure is located in two sites (maybe your company has divisions in different geographical locations). You would like to easily access services available in DC2 from local site in DC1 and vice versa. Without complex VPN and routing configuration. You can run two instances of Cloud Redirector (technology preview) on 2 machines - each in one DC.
java -Xms512m -Xmx512m -Dcrdi.config=C:/CRDI/crdi.client.properties -jar crdi.jar
This is a master configuration. Frontlink mapping contain mapping of transport TCP and UDP ports available in master's local network to services defined in slave's local network. Backlink mapping contain mapping of services exposed via CDRI to master's local network. Shared secret is used as a security key agreement between sites (also all data transferred between sites is encypted with dynamic key). Web App credentials are needed to access CRDI www interface.
Example of client config:
crdi.siteId=client
crdi.backlinkMapping=udp:7500=udp:127.0.0.255:7500,udp:7474=udp:127.0.0.255:7474,udp:7475=udp:127.0.0.255:7475
crdi.frontlinkMapping=40521=1521,udp:7500=udp:7500,udp:7474=udp:7474,udp:7475=udp:7475,7500=7500,7474=7474,7475=7475,7222=7222,8080=8080,40000=80
crdi.controlPort=32765
crdi.sibling=212.76.100.110:32768
crdi.transportPortRange=7000-9000,40000-41000
crdi.udpTransportPortRange=7000-9000,40000-41000
crdi.logLevel=TRACE
crdi.sharedSecret=passw0rd
crdi.webAppCredentials=admin:admin
java -Xms512m -Xmx512m -Dcrdi.config=C:/CRDI/crdi.client.properties -jar crdi.jar
czwartek, listopada 22, 2012
Przykłady na schemacie Oracle HR
select sys.dbms_xmlgen.getxml('select e.first_name || '' '' ||
e.last_name as full_name, d.manager_id as manager_id, d.department_name,
l.city, cursor(select em.first_name || '' '' || em.last_name as
full_name, j.job_title from hr.employees em, hr.jobs j where
em.manager_id = d.manager_id and em.job_id = j.job_id) as employee from
hr.departments d, hr.employees e, hr.locations l where d.location_id =
l.location_id and (l.city like ''' || ? || ''') and e.employee_id =
d.manager_id') as xml from dual
piątek, listopada 09, 2012
Usługa ESB na wielu transportach
Świat idzie do przodu i ESB powinno wystawiać tę samą usługę jako SOAP over HTTP i SOAP over JMS, a od jakiegoś czasu oczekiwany jest REST+JSON. W Tibco do pierwszych dwóch można wykorzystać kontrolkę serwis, a do REST+JSON wystawić HTTP Receivera tłumaczącego wejście za pomocą biblioteki Staxon do XML-a i podać obiekt XML do tej samej implementacji serwisu.
środa, listopada 07, 2012
Architekt
Ilu architektów potrzebnych jest do EAI?
- architekt od wypracowanych technologicznych standardów i bibliotek kodu (adaptuje technologie, tworzy frameworki, szablony, przykłady)
- architekt od procesów wytwarzania oprogramowania (definiuje kroki związane z analizą, dewelopmentem, testowaniem, wdrażaniem, usuwaniem błędów)
- architekt od standardów wytwarzania oprogramowania (definiuje przyjęte wzorce projektowe, techniki, zasady kodowania, używania API)
- architekt od infrastruktury (sprzęt, sieć, storage, systemy operacyjne, wysoka dostępność)
poniedziałek, sierpnia 27, 2012
UDDI w Tibco Designerze
UDDI w Tibco Designerze obsługiwane jest w wersji 2-giej. Funkcjonalność ma charakter publikacji serwisów do katalogu w celu ich zidentyfikowania. Nie można bezpośrednio zaimportować wyszukanej usługi, należy samemu spojrzeć na WSDL or Access URL. Na obrazkach poniżej Apache Juddi v2 w dystrybucji tomcatowej.
niedziela, lutego 19, 2012
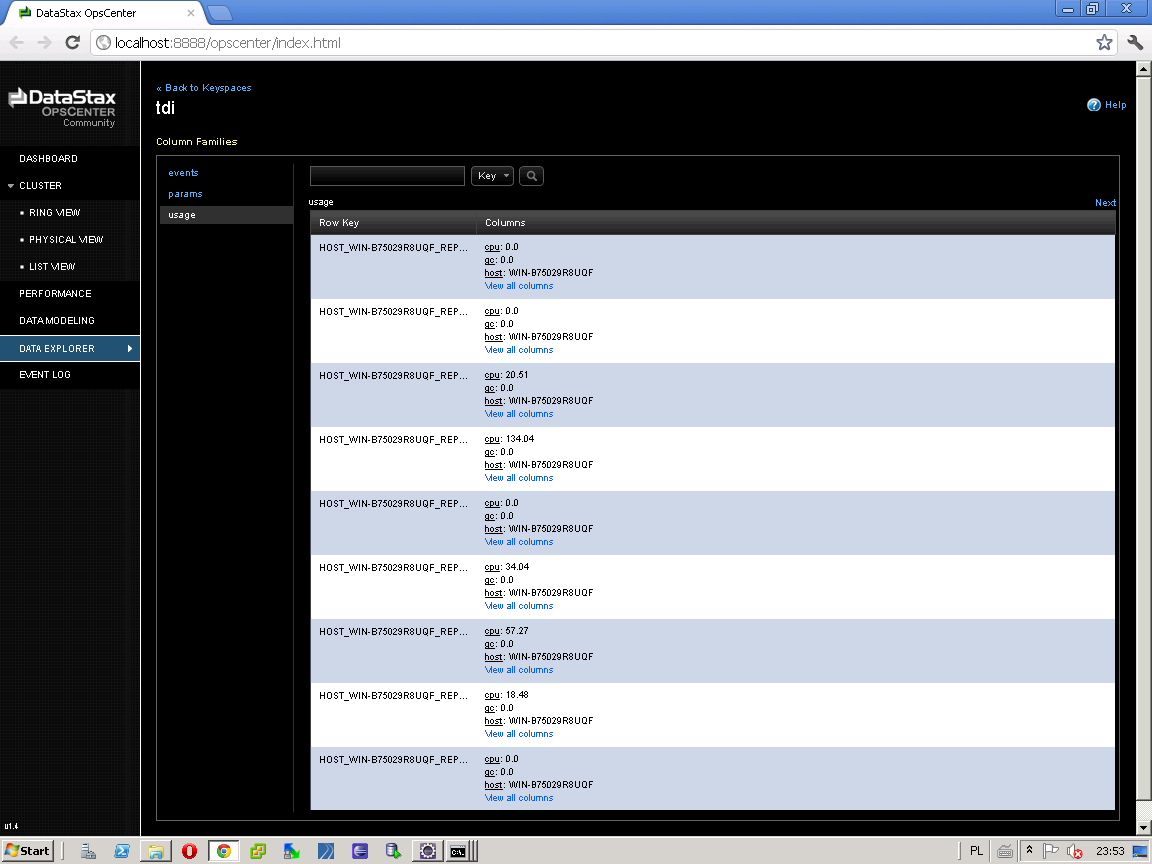
TDI NoSQL
TDI podłączone do kilkuset komponentów Tibco BusinessWorks obsługujących procesy dotykające kilkunastu milionów klientów potrafi dość szybko i skutecznie zapełniać terowego Oracle-a. Regularne czyszczenie tablespace-a 1TB jest uciążliwe, a poza tym szkoda kasowanych danych - za okres 12 miesięcy można by odczytać ciekawe trendy. Do gry wkracza rozwiązanie marketingowo nazwane Long Term NoSQL Storage.niedziela, października 23, 2011
KISS HA
Dlaczego wyszukiwarka Google nie pada tak jak od czasu do czasu chmury? Bo zamiast klastra używają grida. Po co stawiać na active/standby skoro można mieć bardziej niezawodne active/active, do tego taniej. Google polega na dużej liczbie redundantnych i z założenia zawodnych węzłów (wewnętrznie używają nawet patcha pozwalającego na działanie sprzętu na częściowo uszkodzonych pamięciach RAM).
Wróćmy jednak do obrazków i frameworka Solaris SMF, służącego do zarządzania usługami. SMF jest w stanie zapewnić, że proces zdefiniowany w usłudze w przypadku awarii zostanie wznowiony. SMF obsługuje zależności między usługami. W przypadku lokalnego klastra Tibco możemy zdefiniować wirtualne usługi typu baseline-domain, od których będą zależeć konkretne adaptery i brokery. Wtedy wyłączenie lub włączenie domeny będzie włączać lub wyłączać całą grupę komponentów danej domeny.
Do zastosowań active/active wcale nie jest potrzebny Veritas Cluster ani Sun Cluster, SMF z powodzeniem daje radę.
sobota, września 17, 2011
Push&Commit w Tibco
Zacznijmy od tego, że Tibco BusinessWorks w zasadzie nie wspiera transakcji rozproszonych XA. Napisałem "w zasadzie" dlatego, że Tibco BusinessWorks JDBC connection pooling źle działa z TIBCO BusinessWorks XA Transaction Manager (Arjuna kupiona przez Tibco w wersji OEM) - xa_suspend(xid) i xa_resume(xid) wołane na fizycznie różnych połączeniach z bazą Oracle generują błąd (podobnie jak xa_suspend(xid) i xa_start(xid) wołane na tym samym połączeniu). Obejście to ustawienie rozmiaru puli JDBC oraz FlowLimit/MaxJobs na 1. Problem wynika z architektury silnika BW. Można rozwiązać go stosując sterownik-wrapper JDBC przypinający instancję procesu Tibco do pojedynczego połączenia.
Jest inne (też złe) obejście realizowane przez następujący wzorzec projektowy: Implementacja usługi rozbita jest na dwie części - push i commit/pop. W części push klient usługi wysyła standardowy request, który jest walidowany technicznie i biznesowo. Jeśli request nie przechodzi walidacji, klient otrzymuje odpowiedź o błędzie natychmiast. Jeśli request jest poprawny, to wołany jest nowy proces w trybie spawn i zwracana jest odpowiedź o przyjęciu komunikatu do obsługi zawierająca identyfikator transakcji. Stworzony proces aktywnością Wait czeka na commit transakcji. Proszę zauważyć, że na tym etapie obsługi komunikatu nie ma czekania wątków z blokowaniem - nie czeka się na zakończenie stworzonego procesu, a aktywność Wait zwalania wątek do puli Engine Threads. Klient wysyła kolejny komunikat potwierdzający transakcję i w odpowiedzi dostaje dane, które powinien przy standardowym podejściu dostać na wyjściu operacji request-reponse lub informację o błędzie (zazwyczaj błąd grubego kalibru typu transaction rollback, end of communication stream, connection closed). W innej wersji wzorca klient może dostać odpowiedź od razu (IPC procesu rodzica z dzieckiem), wtedy operacja commit nie zwraca żadnych danych.
Czy takie podejście ma plusy? Klient między wywołaniem requestu a commitem może po swojej stronie prowadzić jakieś przetwarzanie danych, a nie bezczynnie czekać. Wzorzec dużą wagę przykłada do walidacji danych. Klient decyduje o czasie wykonania operacji commit, a więc ma dużą domniemaną kontrolę nad timeout-ami. Poprzez odpowiednie sygnalizowanie stanu przetwarzania (Notify: processing) i dobrze dobrane czasy wygasania notyfikacji, klient po wywołaniu aktywności 'Wait for response' ma dokładną odpowiedź biznesową lub status, że przetwarzanie jeszcze trwa lub że już się skończyło poprawnie lub wystąpił błąd. Istnienie statusu przetwarzania wymusza wzorzec.
Minusy: przy źle określonych uwarunkowaniach czasowych możemy mieć do czynienia z pollingiem, przeciążeniem pamięci komponentu Tibco, przedwczesnym kasowaniem odpowiedzi. Nadal nie będziemy mieli prawdziwej transakcji rozproszonej (xa_prepare jest persystentne): jeśli operacja commit dla pierwszej w kolejności usługi zwróci błąd, nie wywołamy operacji commit dla pozostałych usług i jesteśmy szczęśliwi, ale jeśli po paru udanych commitach dostaniemy błąd, to nie jesteśmy w stanie wycofać już transakcji (a przy prawdziwym xa_prepare można zrobić rollback). Jeśli nie używamy JMS-a tylko 'spawn process', to oczekująca transakcja nie przetrwa restartu pojedynczego komponentu. Prawdziwe XA radzi sobie przy błędach infrastruktury technicznej, ten wzorzec nie. Wzorzec jest trudny w poprawnej implementacji.
Wnioski: Tibco, SOA, Order Management - wybierz dowolne dwa. Nie mając prawdziwej transakcyjności zmuszeni jesteśmy do stosowania kompensacji (saga pattern), co nie jest szybkim i prostym rozwiązaniem pudełkowym.
piątek, września 02, 2011
Sir Isaac Newton a wdrożenia
'Jeśli na ciało nie działa żadna siła lub siły działające równoważą się, to ciało pozostaje w spoczynku lub porusza się ruchem jednostajnym prostoliniowym'. Dewelopment dąży do jak najszybszego wdrożenia projektu na produkcję, a co się z tym wiąże przejścia do etapu: protokół odbioru, faktura, przelew... Utrzymanie dąży do blokowania kodu niesprawdzonego i wadliwego. Jeśli siły dewelopmentu i utrzymania się równoważą to mamy punkt równowagi, w którym projekty wdrażane są w akceptowalnym czasie i w stanie produkcyjnej używalności (brak błędów krytycznych i ważnych, więcej niż 97% komunikatów jest przetwarzanych poprawnie). Jeśli utrzymanie lub dewelopment zaniedbują proces Service Transition to mamy ruch środowiska produkcyjnego jednostajny prostoliniowy ku dużym i długotrwałym problemom.ESB obok EAI
EAI tradycyjnie i historycznie jest zbudowane wokół JMS-a, ale starzeje się lub inaczej - nie nadąża za standardami: WS-Addressing, WS-Transactions, interoperacyjność z .NET. Do integracji platformy integracyjnej z resztą świata paradoksalnie potrzebna staje się nowa warstwa. Warstwą okalającą EAI może być nowoczesne lekkie ESB realizujące routing i transformacje z WebService-ów na JMS-a. Innymi słowy: channel na ESB, broker na EAI. ESB dodatkowo może realizować logowanie komunikatów, wirtualizację usług i QoS (service registry, load balancing, failover, powtarzanie wywołań w przypadku błędów technicznych, wymuszanie SLA), gdzie te ostatnie to kwestia konfiguracji a nie dewelopmentu.
Subskrybuj:
Posty (Atom)